Direct naar8 onderdelen
Meet schaalbaar hoe vaak AI-systemen je merk noemen, aanbevelen en als bron gebruiken ten opzichte van concurrenten.
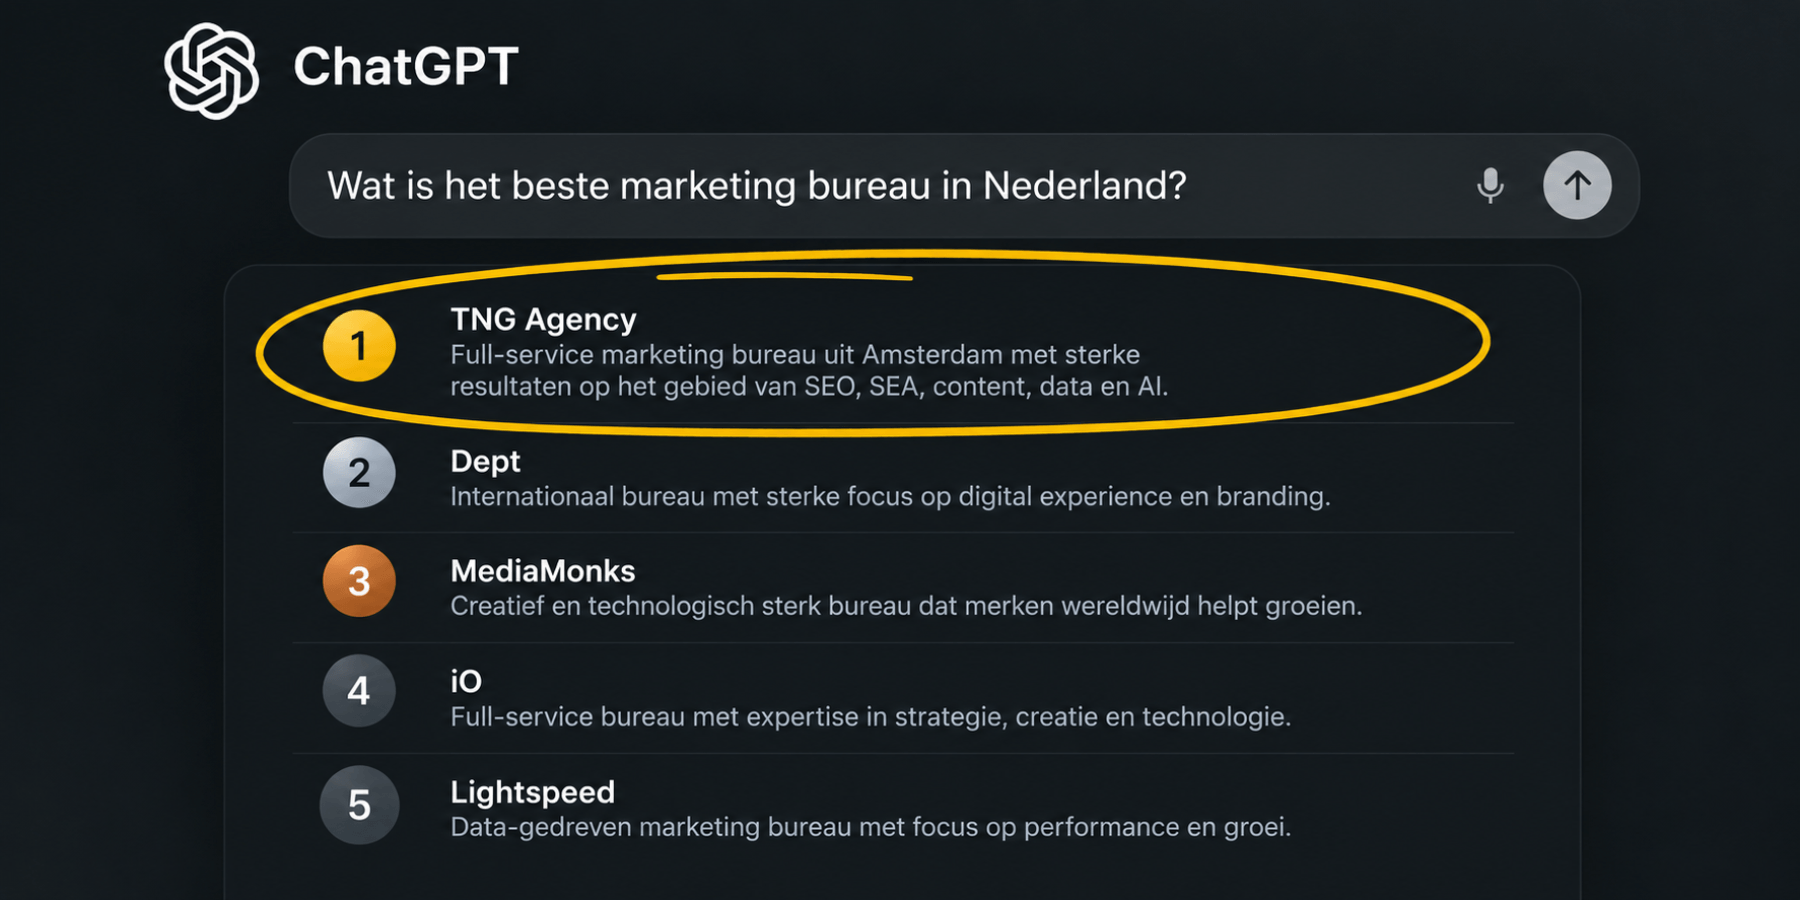
Noemt ChatGPT jouw merk wanneer een potentiële klant om advies vraagt? En zo ja, wordt het merk aanbevolen, neutraal genoemd of alleen gebruikt als bron? Eén handmatige prompt geeft daar geen betrouwbaar antwoord op. AI visibility meten vraagt om een vaste vragenset, meerdere AI-systemen, herhalingen en een datamodel waarin ieder antwoord hetzelfde wordt beoordeeld. TNG schaalt die aanpak met automatisering, zodat tientallen of honderden vragen tegelijk kunnen worden getest.
Waarom AI visibility meten geen losse prompttest is
Een AI-antwoord is geen vaste zoekresultatenpagina. ChatGPT, Gemini en andere systemen kunnen op verschillende momenten andere merken, bronnen en argumenten noemen. Ook de formulering van een vraag beïnvloedt het antwoord. “Welk bureau helpt met AI-vindbaarheid?” kan een andere lijst opleveren dan “Wie kan mijn bedrijf zichtbaar maken in ChatGPT?”
Een consumentenapp werkt bovendien niet altijd hetzelfde als de API van dezelfde aanbieder. Een Nederlandse benchmark uit september 2026 maakte dat concreet: 87 vragen aan zeven AI-engines leverden 1.298 antwoorden op. Taalmodellen kregen dezelfde vraag meerdere keren. Zelfs de ChatGPT-app en ChatGPT via de API hadden niet exact dezelfde favorieten.
De conclusie is niet dat meten onmogelijk is. De conclusie is dat een losse uitslag weinig zegt. Je hebt een steekproef nodig die groot genoeg is om patronen te zien en een methode die bij iedere herhaling gelijk blijft. Dat is de basis van een volwassen GEO-aanpak.
Begin met vragen die echte klanten stellen
Een goede meting begint bij vragen die iemand vóór een aankoop stelt. “Is merk X goed?” meet vooral of AI informatie over dat merk vindt. “Welke partijen kunnen mij helpen?” meet of het merk spontaan in de keuzelijst verschijnt.
Wij verdelen de vragenset daarom over meerdere typen intentie:
- Algemene oriëntatie: welke oplossingen of aanbieders passen bij dit probleem?
- Categorievragen: welke merken zijn sterk binnen een specifieke dienst of productgroep?
- Vergelijkingen: welke partijen passen bij een bepaald budget, type organisatie of gebruikssituatie?
- Sector- en regiovragen: welke aanbieders zijn relevant voor deze branche of locatie?
- Probleemvragen: hoe los ik een herkenbaar klantprobleem op en wie kan daarbij helpen?
- Merkvragen: wat zegt AI over het merk, welke sterke punten noemt het en welke alternatieven worden gegeven?
De eerste vijf groepen testen onbeïnvloede zichtbaarheid. Daar hoort de merknaam niet in de prompt te staan. Merkvragen vormen een aparte diagnose. Zo voorkom je dat een hoge score vooral ontstaat doordat je zelf het merk al in iedere vraag hebt genoemd.
Maak van prompts een versieerbare dataset
Zodra de vragen zijn gekozen, krijgt iedere prompt een vaste identificatie. We bewaren de exacte tekst, taal, intentie, sector, regio en relevante concurrenten. Ook model, interface, meetdatum en instellingen horen bij het resultaat. Daarmee wordt een prompt geen losse chat meer, maar een datapunt dat later opnieuw kan worden uitgevoerd.
Als de vraag iedere maand anders wordt gesteld, weet je niet of een verandering door betere zichtbaarheid of door de formulering komt. De kernset blijft daarom gelijk en krijgt bij inhoudelijke wijzigingen een nieuw versienummer.
We voeren belangrijke vragen meerdere keren uit. Niet om één “juist” antwoord af te dwingen, maar om de variatie zichtbaar te maken. Een merk dat in één van de tien antwoorden voorkomt, staat er anders voor dan een merk dat in acht van de tien antwoorden wordt genoemd.
Zo schalen we honderden AI-vragen tegelijk
Handmatig dezelfde prompts in verschillende tools plakken werkt voor een snelle verkenning. Het schaalt niet, is foutgevoelig en maakt resultaten lastig vergelijkbaar. Daarom sturen we vragensets geautomatiseerd naar de beschikbare modellen en zoekervaringen. Waar API's batchverwerking ondersteunen, kunnen veel verzoeken als één meettaak worden klaargezet. Andere controles draaien parallel of volgens een vast schema.
Iedere aanvraag krijgt een uniek ID. Zo koppelen we resultaten aan de juiste vraag, engine, herhaling en meetronde, ook als antwoorden in een andere volgorde terugkomen. Een analyse haalt vervolgens merken, posities, bronnen en toon uit de ruwe tekst.
Het resultaat komt samen in dashboarding. Daar zie je niet alleen de laatste score, maar ook welke promptclusters verbeteren, waar een concurrent terrein wint en welke bron vaker door een AI-systeem wordt gebruikt.
De KPI's voor LLM- en AI-zichtbaarheid
Een totaal aantal vermeldingen is niet voldoende. Een merk kan vaak voorkomen doordat het kritisch wordt besproken of in irrelevante vragen opduikt. Wij combineren daarom meerdere signalen:
- Mention rate: het percentage antwoorden waarin het merk wordt genoemd.
- First mention rate: hoe vaak het merk als eerste relevante optie verschijnt.
- Share of voice: het aandeel vermeldingen ten opzichte van geselecteerde concurrenten.
- Recommendation rate: hoe vaak een vermelding daadwerkelijk als aanbeveling is geformuleerd.
- Citation rate: hoe vaak de eigen website als zichtbare bron wordt gebruikt.
- Source overlap: welke externe domeinen jouw merk én concurrenten ondersteunen.
- Message accuracy: of diensten, kenmerken en bewijs correct worden beschreven.
- Consistency: hoe stabiel de uitkomst is tussen herhalingen, engines en meetmomenten.
Maak deze cijfers altijd uitsplitsbaar naar intentie, sector en model. Een gemiddelde kan verhullen dat je merk goed zichtbaar is op informatieve vragen, maar volledig ontbreekt wanneer iemand om een shortlist vraagt.
Meten wat Google rapporteert en wat daarbuiten gebeurt
Google geeft inmiddels in Search Console informatie over zichtbaarheid binnen generatieve AI-functies. Dat laat zien welke pagina's als resultaat of bron verschijnen, maar beantwoordt niet alle vragen.
Search Console laat bijvoorbeeld niet zien waarom Gemini een concurrent aanbeveelt of hoe vaak ChatGPT jouw merk noemt in een aankoopgerichte vergelijking. Daarom combineren we platformdata met eigen promptmetingen. De eerste bron laat zien wat er binnen een platform gebeurt. De tweede maakt merkvermeldingen, concurrenten, volgorde, toon en brongebruik vergelijkbaar over meerdere systemen.
Van meting naar concrete verbeteringen
De waarde zit niet in een mooi percentage, maar in wat je ermee doet. Wanneer AI een concurrent vaak aanbeveelt, kijken we welke argumenten en bronnen steeds terugkomen. Mist jouw merk een duidelijke categoriepagina? Zijn cases alleen visueel beschikbaar en nauwelijks leesbaar voor crawlers? Wordt een dienst op verschillende pagina's telkens anders benoemd? Of gebruiken andere websites een duidelijkere omschrijving van de concurrent?
Daaruit volgt een prioriteitenlijst. Soms ligt de oplossing in betere vergelijkingen, originele data of bewijs uit cases. Soms is technische SEO de bottleneck omdat informatie slecht crawlbaar is of entiteiten niet consequent worden uitgelegd. Externe vermeldingen zijn alleen zinvol als ze relevant en controleerbaar zijn.
Na een wijziging draaien we dezelfde vragenset opnieuw. Daardoor wordt zichtbaar of het aandeel vermeldingen stijgt, of de beschrijving van het merk nauwkeuriger wordt en of nieuwe bronnen in antwoorden verschijnen. Zo verandert AI-zichtbaarheid van een momentopname in een meetbaar optimalisatieproces.
Wat een goede AI visibility-meting oplevert
Een goede meting belooft geen vaste nummer-éénpositie in ChatGPT. Zo werkt een generatief antwoord niet. De waarde is dat je systematisch ziet waar je merk wel en niet wordt meegenomen in de digitale oriëntatie van klanten.
Met een vaste promptset, meerdere engines, herhalingen en automatische verwerking ontstaat een bruikbare nulmeting. Iedere content-, techniek- of autoriteitsverbetering kan daarna tegen dezelfde basis worden getest. Het concept blijft hetzelfde als handmatig vragen stellen aan AI. Het verschil is schaal: honderden gecontroleerde vragen in plaats van één screenshot.